

Strukturierte Daten (SEO)
Strukturierte Daten stellen Suchmaschinen gezielt weiterführende Informationen bereit, die unter einem Treffer auf der Ergebnisseite angezeigt werden sollen. Das Wicht...
- 05 März, 2026
- 0 Kommentare
Eine Entität (engl. Entity) bezeichnet im Kontext von Suchmaschinenoptimierung (SEO) und Generative Engine Optimization (GEO) ein eindeutig identifizierbares Objekt, ein Konzept, eine Person, einen Ort oder ein Ereignis. Diese Entitäten bilden sich folglich aus der Summe von vielen einzelnen Daten wie beispielsweise ein Alter, eine Aussehensbeschreibung, einer Berufstätigkeit und weiterer Merkmale, die durch den Bezug zueinander erst eine einzigartige Person bilden.
Während traditionelle Suchmaschinen Dokumente anhand von reinen Keywords analysieren, verarbeiten KI-Systeme Inhalte auf Basis von Entitäten und deren Beziehungen zueinander.
Eine Entität muss klar von anderen Elementen abgegrenzt werden können. Deswegen zeichnet sie sich durch die folgenden drei Eigenschaften aus:
Schon im Jahr 2012 formulierte Google mit der Initiative „Things Not Strings“ den fundamentalen Wandel der Informationsverarbeitung, die einerseits die Manipulation der Search Engine Result Pages (SERPs) erschwerte, aber auch die Suche selbst nachhaltig qualitativ optimierte.
Beispiel:
Die eingeführte entitätenbasierte Suche lieferte übrigens auch die Grundlage für die heutigen Rich Snippets, die man als klassische Vorstufe der stark individualisierten KI-Antworten sehen kann.
Die Weiterentwicklung der Algorithmen von der klassischen Suchmaschine zu KI-Systemen hat ihre Funktionsweise der Suche nachhaltig verändert. Das Konzept der Entitäten SEO aus dem Jahre 2012 bildet die Grundlage für die heutige Optimierung für KI-gestützte Suchmaschinen (GEO).
Die folgende Tabelle zeigt die technologischen Meilensteine, die Google seither bis an den aktuellen Stand der fortschrittlichen KI-Suche geführt hat:
| Algorithmus / Update | Jahr | Technologische Neuerung & Bedeutung für Entitäten SEO |
| Google Knowledge Graph | 2012 | Einführung der zentralen Datenbank zur Speicherung von Entitäten und deren Beziehungen. |
| Hummingbird | 2013 | Grundlegender Austausch des Such-Kernsystems hin zur semantischen Suche. Ermöglichte das Verstehen ganzer Satzstrukturen. |
| RankBrain | 2015 | Einsatz von Machine Learning zur Interpretation unbekannter oder mehrdeutiger Suchanfragen durch Entitäten-Zuordnung. |
| Gemini & ChatGPT | Ab 2023 | Große KI-Sprachmodelle (LLMs), die Entitäten-Netzwerke nutzen, um komplexe und individuelle Antworten auf spezifische Suchanfragen zu generieren. |
In der klassischen Suchmaschinenoptimierung ging es darum, Webseiten für Keyword-Suchanfragen auf vorderen Positionen der Suchergebnisseiten (SERPs) zu platzieren. Dafür reichten lange Zeit eine einfache Keyword Analysen und dann wurden irgendwann semantische Analysen notwendig.
In der KI Suche (wie in Google AI Overviews, Perplexity, ChatGPT oder Gemini) generiert die Suchmaschine direkt passgenaueste Antworte aufgrund vom erkannten Kontext in der Suchanfrage.
Suchmaschinen nutzen NLP & Linguistik-Konzepte (Natural Language Processing), um unstrukturierten Text auf Webseiten in strukturierte Daten zu übersetzen. Dieser Prozess lässt sich in 5 Schirtte gliedern,
Bei der Entity Extraction (Extraktion von Entitäten) analysiert ein Algorithmus einen Text und isoliert die darin vorkommenden Informationen. Das enthaltene Teilverfahren Named Entity Recognition (NER) identifiziert hierbei konkrete Eigennamen, Organisationen, Orte, Zeitangaben und Produkte.
[Backlinked GmbH] = Organisation, [Bonn] = Ort.Begriffe, die mehrdeutig sein können, werden durch die Entity Disambiguation (Bedeutungsklärung) anhand des umliegenden Kontexts eindeutig.
Nicht jede erkannte Entität ist für ein Thema gleich wichtig. Die Entity Salience (Gewichtung) ist ein Zahlenwert (in der Regel zwischen 0,0 und 1,0), der angibt, wie zentral eine Entität für das Gesamtthema einer Seite ist.
Die Co-Occurrence (Koinzidenz) beschreibt das häufige gemeinsame Auftreten bestimmter Entitäten in fachlich relevanter und vertrauenswürdiger Literatur im Internet.
Moderne KI-Modelle übersetzen Entitäten in sogenannte Vektoren. In einfachen Worten Beschrieben, sind Vektoren Positionen in einem mehrdimensionalen Koordinatensystem (ein Vektorraum). Liegen hier die Entitäten bzw. Vektoren nah beieinander, handelt es sich automatisch um semantisch verwandte Entitäten.
Das Modell kann also durch Entfernungen im Vektorraum berechnen, wie relevant bestimmte Entitäten zueinander sind und folglich auch die Relevanz von weiterführenden Informationen bei der Beantwortung einer Suchmaschine einschätzen.
Im Vergleich zur früheren, keywordbasierten Beantwortung von Suchanfragen liegt hierin der Hauptunterschied, denn es müssen keine identischen Wörter mehr abgeglichen werden, um Kontext herzustellen.
Ein Knowledge Graph ist eine graphische Datenbank, in der Entitäten und ihr Verhältnis zueinander gespeichert werden. Sie werden als sogenannte Knoten (Nodes) angelegt und deren Verbindungen als Kanten (Edges) verzeichnet.
Innerhalb dieses Graphen werden diese Informationen einer Entität nach dem Prinzip der Triplets strukturiert. Einfach beschrieben: Sie werden in Subjekt, Prädikat und Objekt unterteilt:
| Art | Bedeutung | Beispiel |
| Subjekt | Ausgangs-Entität | Backlinked |
| Prädikat | Beziehung zu Objekt | ist Anbieter von |
| Objekt | Ziel-Entität | Offpage Optimierungen |
Neben dem Knowledge Graph nutzen Google und Co. außerdem offene und strukturierte Datenbanken, um den eigenen Knowledge Graph aufzubauen und die eigens gecrawlten Informationen abzugleichen:

Kleiner Praxis-Tipp von mir:
Wikidata ist wie Wikipedia ein offenes Projekt. Du kannst also einfach selbst einen entsprechenden Eintrag für eine Entität dort anlegen! Die Bedingung dafür ist allerdings, dass du die Relevanzkriterien von Wikidata erfüllst. Solltest du oder dein Unternehmen bereits einen Wikipedia-Artikel haben, erfüllst du bereits ein Relevanzkriterium.
DBpedia ist zwar ein geschlossenes Projekt, speist sich aber direkt aus der Wikipedia und baut ihre Datenbank vor allem aus den dortigen Infoboxen auf.
Solltest du es schaffen, in diesen Datenbanken einen Eintrag zu bekommen, steigt die Relevanz für deine Entität im Google Knowledge Graph automatisch.
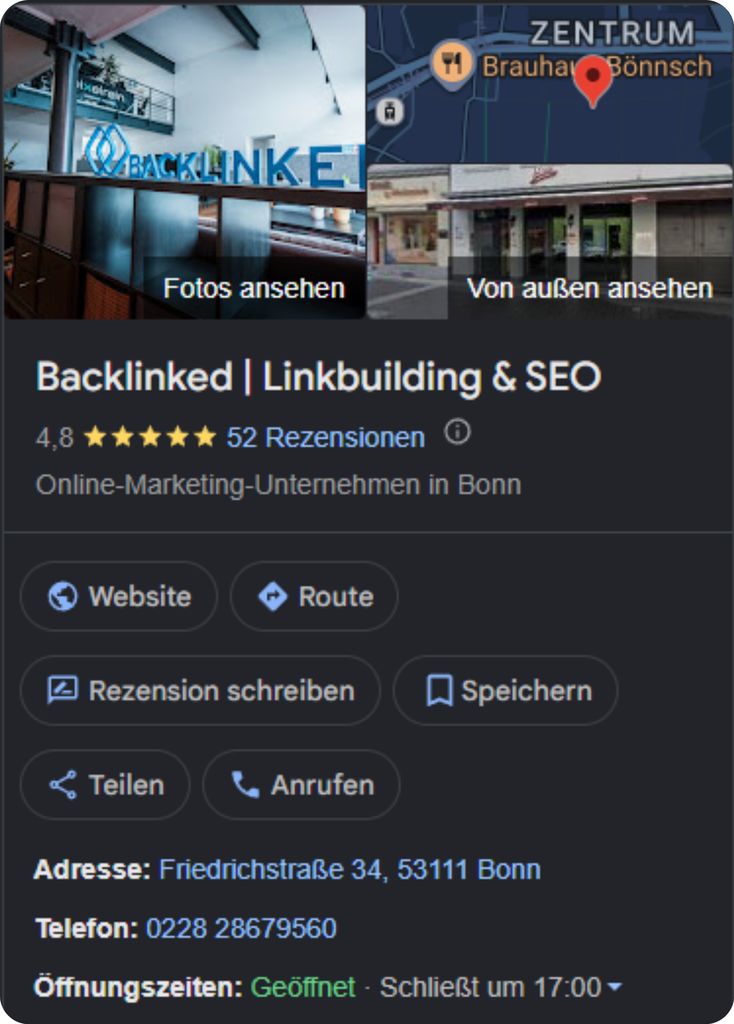
Sobald eine Entität vom System hinter dem Knowledge Graph als ausreichend relevant und verifiziert eingestuft wird, zeigt die Suchmaschine in den Suchergebnissen ein Google Knowledge Panel an. Dies ist der Informationskasten am rechten Bildschirmrand (Desktop) oder im oberen Bereich (Mobil), der strukturierte Fakten zur gesuchten Entität zusammenfasst.
Der Knowledge Panel ist für dein Unternehmen außerdem ein zentraler Faktor für dein Local SEO und kann folgende Informationen Umfassen:
Diese Daten werden zusammen mit deinen Angaben aus dem Google Business Profil dynamisch angezeigt und ergeben so ein Gesamtbild aus allen relevanten Informationen.
Neben dem oben genannten Informationen gibt es natürlich konkrete Handlungsempfehlungen, die dafür sorgen, dass deine Inhalte auch nach den neuen Methoden der Suchalgorithmen sichtbar bleiben.
Die 4 wichtigsten Faktoren, die du direkt umsetzen kannst, haben wir dir folgend aufgelistet:
SEO-Tools sind toll. In der Contentoptimierung hängen sie aber leicht hinterher und geben zu oberflächliche Basis-Informationen, die zur modernen Contenterstellung oftmals nicht reichen. Wir haben dieses Thema bereits an mehreren Stellen aufgearbeitet und können euch die folgenden Inhalte ans Herz legen:
Damit Suchmaschinen Entitäten auf deiner Webseite ohne aufwendige Textanalyse schnell und korrekt zuordnen können, nutzt du am besten Structured Data Entity Markups (Strukturierte Daten).
Was das genau ist, haben wir in unserem Wiki-Beitrag Was sind Strukturierte Daten? behandelt.
Besonders das Eigenschaftsfeld sameAs ist hier erwähnenswert, denn es lässt dich eine Entität auf deiner Website direkt mit ihrer Repräsentanz in offiziellen Datenbanken wie Wikidata oder dem Google Knowledge Graph verknüpfen.
Wieso die Nutzung der Schema.org Markups für deine Sichtbarkeit in KI-Systemen allgemein von zentraler Bedeutung ist, haben wir in folgendem Blogartikel und Video erklärt:
Damit deine Marke, dein Produkt oder eine relevante Person aus deinem Unternehmen von Suchmaschinen und KI-Systemen als eigenständige Entität verstanden wird, reicht die Veröffentlichung von Inhalten auf der eigenen Website oftmals nicht aus.
Das oben erklärte Prinzip der Co-Occurence ist für Google und andere KI-Systeme die bestmögliche Methode, um Relevanz zu messen. Und genau darauf kannst du gezielt Einfluss nehmen, indem du dafür sorgst, dass Google auch außerhalb deiner Website Informationen zur Verifikation deiner Inhalte findet:
Das Thema 'Expertenstatus' für den Aufbau von wirksamen Entitäten haben wir noch konkreter in folgendem Content behandelt:
Google bietet mit der Google Natural Language API eine öffentlich zugängliche Schnittstelle an, mit der Texte auf ihre Entitäten hin analysiert werden können.
Du kannst dieses Tool konkret dafür nutzen, folgende Sachverhalte zu prüfen:
sameAs ausgestatten werden).So kannst du nicht nur feststellen, ob zentrale Entitäten in deinem Text vorhanden sind, sondern auch durch den Salience-Wert sehen, ob der Text strukturell und semantisch eindeutig aufbereitet ist.
Der Wechsel von Keyword-basierten zu Entitäten-basierten Systemen erfordert eine Anpassung der SEO-Strategie:
Simon ist Geschäftsführer der Pixelrein GmbH & Co. KG und Gründer von Backlinked. Er bringt jahrelange Erfahrung in der strategischen Entwicklung und Skalierung von Digitalprojekten mit. Sein Fokus liegt neben der strategischen Weiterentwicklung von Backlinked auf der datengetriebenen Suchmaschinenoptimierung, um nachhaltige Sichtbarkeit für Marken im DACH-Raum aufzubauen.
Strukturierte Daten stellen Suchmaschinen gezielt weiterführende Informationen bereit, die unter einem Treffer auf der Ergebnisseite angezeigt werden sollen. Das Wicht...

Ein Keyword Cluster (auch Wordlist-Cluster genannt) bezeichnet eine Gruppe von Keywords, die themenrelevante Keywords zusammenfasst. Das Keyword Clustering ist eine Metho...
Linkable Assets sind Inhalte, die von anderen Nutzern besonders gerne und freiwillig verlinkt werden. Denn: Ein Linkable Asset behandelt meist ein Problem, dass mehrere U...